알고리즘 공부를 처음 시작하면서 HackerRank 문제를 하나씩 풀어보고 있다.
이번 문제는 현재 값이 이전까지의 모든 값의 평균보다 큰 경우의 수를 세는 문제다.
문제 자체는 어렵지 않았지만, 처음에는 Python 문법에서 실수하기도 했고 단순하게 구현한 뒤 다시 생각해보니 O(N²) 풀이를 O(N)으로 개선할 수 있는 포인트도 있었다.
이번 글에서는 정답 코드만 남기기보다는
문제 이해
→ 직접 손으로 풀기
→ 가장 단순한 코드 작성
→ 실수 확인
→ 시간복잡도 분석
→ 중복 계산 제거
→ O(N)으로 개선과정을 그대로 정리해보려고 한다.
문제
양의 정수 배열이 주어졌을 때, 각 원소가 자신보다 앞에 있는 모든 원소의 평균보다 큰 경우의 수를 구한다.
첫 번째 원소는 이전 값이 없으므로 비교하지 않는다.
예를 들어 다음 배열이 있다고 하자.
responseTimes = [100, 200, 150, 300]각 값을 순서대로 비교하면 다음과 같다.
| index | 현재 값 | 이전 값 | 이전 평균 | 결과 |
|---|---|---|---|---|
| 0 | 100 | - | - | 비교하지 않음 |
| 1 | 200 | [100] | 100 | count + 1 |
| 2 | 150 | [100, 200] | 150 | 변화 없음 |
| 3 | 300 | [100, 200, 150] | 150 | count + 1 |
따라서 정답은 2다.
문제를 내 말로 다시 정리하기
문장을 코드 조건으로 바꾸면 생각보다 단순하다.
현재 값 > 이전 값들의 평균이면 count를 증가시키면 된다.
첫 번째 원소는 이전 값이 없으므로 건너뛴다.

알고리즘 문제를 처음 풀 때는 바로 코드를 작성하기보다, 이렇게 조건을 먼저 말로 단순화하는 것이 도움이 되는 것 같다.
예제를 손으로 직접 따라가 보기
입력이 다음과 같다고 하자.
[100, 200, 150, 300]index = 0
현재 값은 100.
이전 값이 없기 때문에 비교하지 않는다.
100
↑
skipindex = 1
현재 값은 200.
이전 값은
[100]평균은
100 / 1 = 100이므로
200 > 100count를 증가시킨다.
index = 2
현재 값은 150.
이전 값은
[100, 200]평균은
(100 + 200) / 2 = 150현재 값과 평균이 같다.
문제의 조건은 strictly greater than, 즉 >이므로 같을 경우에는 count를 증가시키지 않는다.
index = 3
현재 값은 300.
이전 값은
[100, 200, 150]평균은
(100 + 200 + 150) / 3
= 150따라서
300 > 150이므로 count를 증가시킨다.
최종 결과는
2이다.
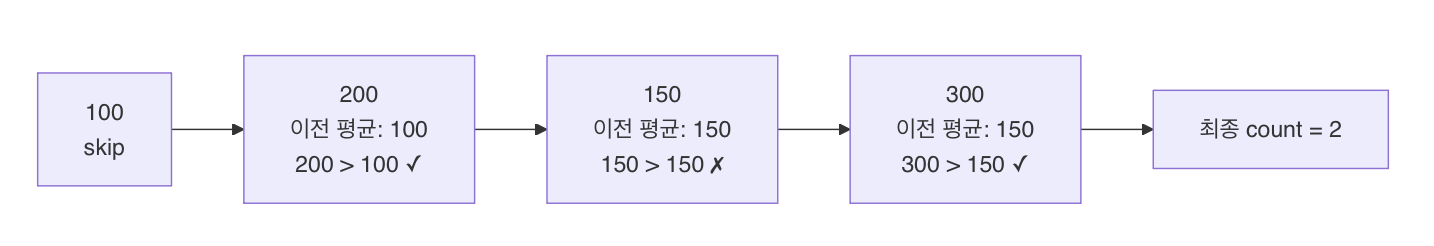
전체 흐름을 그림으로 보면 다음과 같다.
처음 떠올린 풀이
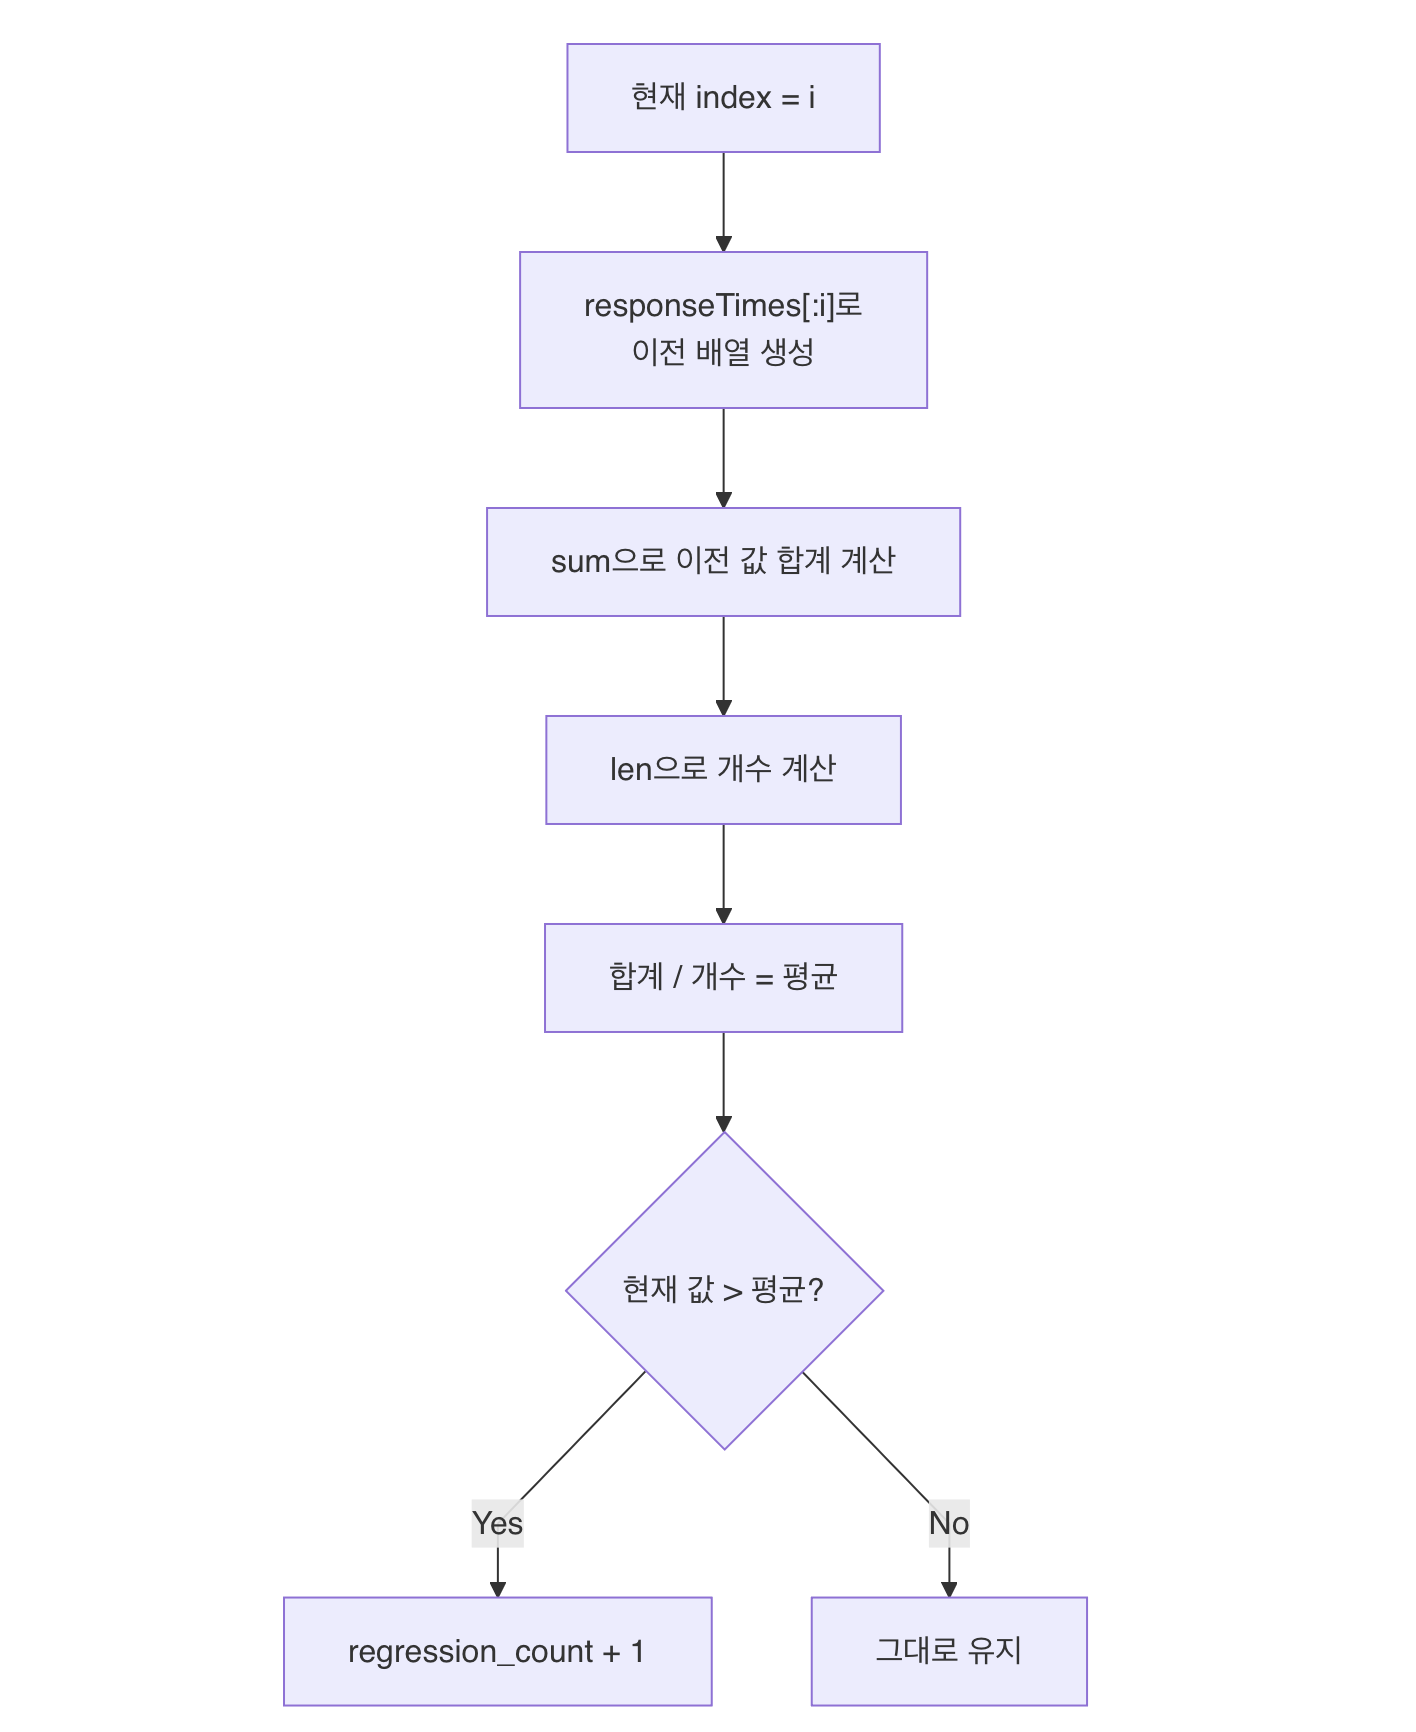
처음에는 문제 문장을 거의 그대로 코드로 옮기려고 했다.
현재 index가 i라면
responseTimes[:i]를 사용하면 현재 값보다 앞에 있는 원소들을 가져올 수 있다.
예를 들어
responseTimes = [100, 200, 150, 300]에서 현재 index가 2라면
responseTimes[:2]의 결과는
[100, 200]이다.
따라서 이전 값들의 평균은
sum(responseTimes[:index]) / len(responseTimes[:index])처럼 구할 수 있다.
1차 풀이
def countResponseTimeRegressions(responseTimes):
    regression_count = 0

    for index, response_time in enumerate(responseTimes):
        if index == 0:
            continue

        previous = responseTimes[:index]
        previous_average = sum(previous) / len(previous)

        if response_time > previous_average:
            regression_count += 1

return regression_count처음 문제를 이해하는 관점에서는 꽤 직관적이다.
처음 풀면서 했던 실수
처음 작성했던 코드에는 다음 부분이 있었다.
count = 0그리고 평균을 구할 때
sum(responseTimes[:index]) / count(responseTimes[:index])처럼 작성했다.
여기에는 두 가지 문제가 있다.
1. 배열 길이는 len()으로 구한다
Python에서 배열의 원소 개수를 구할 때는
len(array)를 사용한다.
따라서 원하는 코드는
len(responseTimes[:index])이다.
2. count를 이미 숫자 변수로 사용하고 있었다
코드 앞에서
count = 0이라고 선언했으므로 count는 정수다.
그런데
count(...)처럼 쓰면 Python 입장에서는
숫자인데 왜 함수처럼 호출하지?
가 된다.
그래서 변수명도 조금 더 역할이 명확하게
regression_count처럼 작성하는 편이 좋아 보였다.
개인적으로 알고리즘을 공부하면서 변수명을 단순히 짧게 쓰는 것보다 역할을 드러내는 것도 꽤 중요하다고 느꼈다.
그런데 이 풀이가 효율적일까?
정답은 만들었지만 한 번 더 생각해볼 부분이 있다.
매 반복마다
responseTimes[:index]를 만든다.
그리고 다시
sum(responseTimes[:index])를 계산한다.
예를 들어 입력이 다음과 같다고 하자.
[100, 200, 150, 300, 400]계산해야 하는 값은 다음과 비슷하다.
index 1
100

index 2
100 + 200

index 3
100 + 200 + 150

index 4
100 + 200 + 150 + 300문제는 100, 200 같은 값들이 계속 반복해서 더해진다는 것이다.
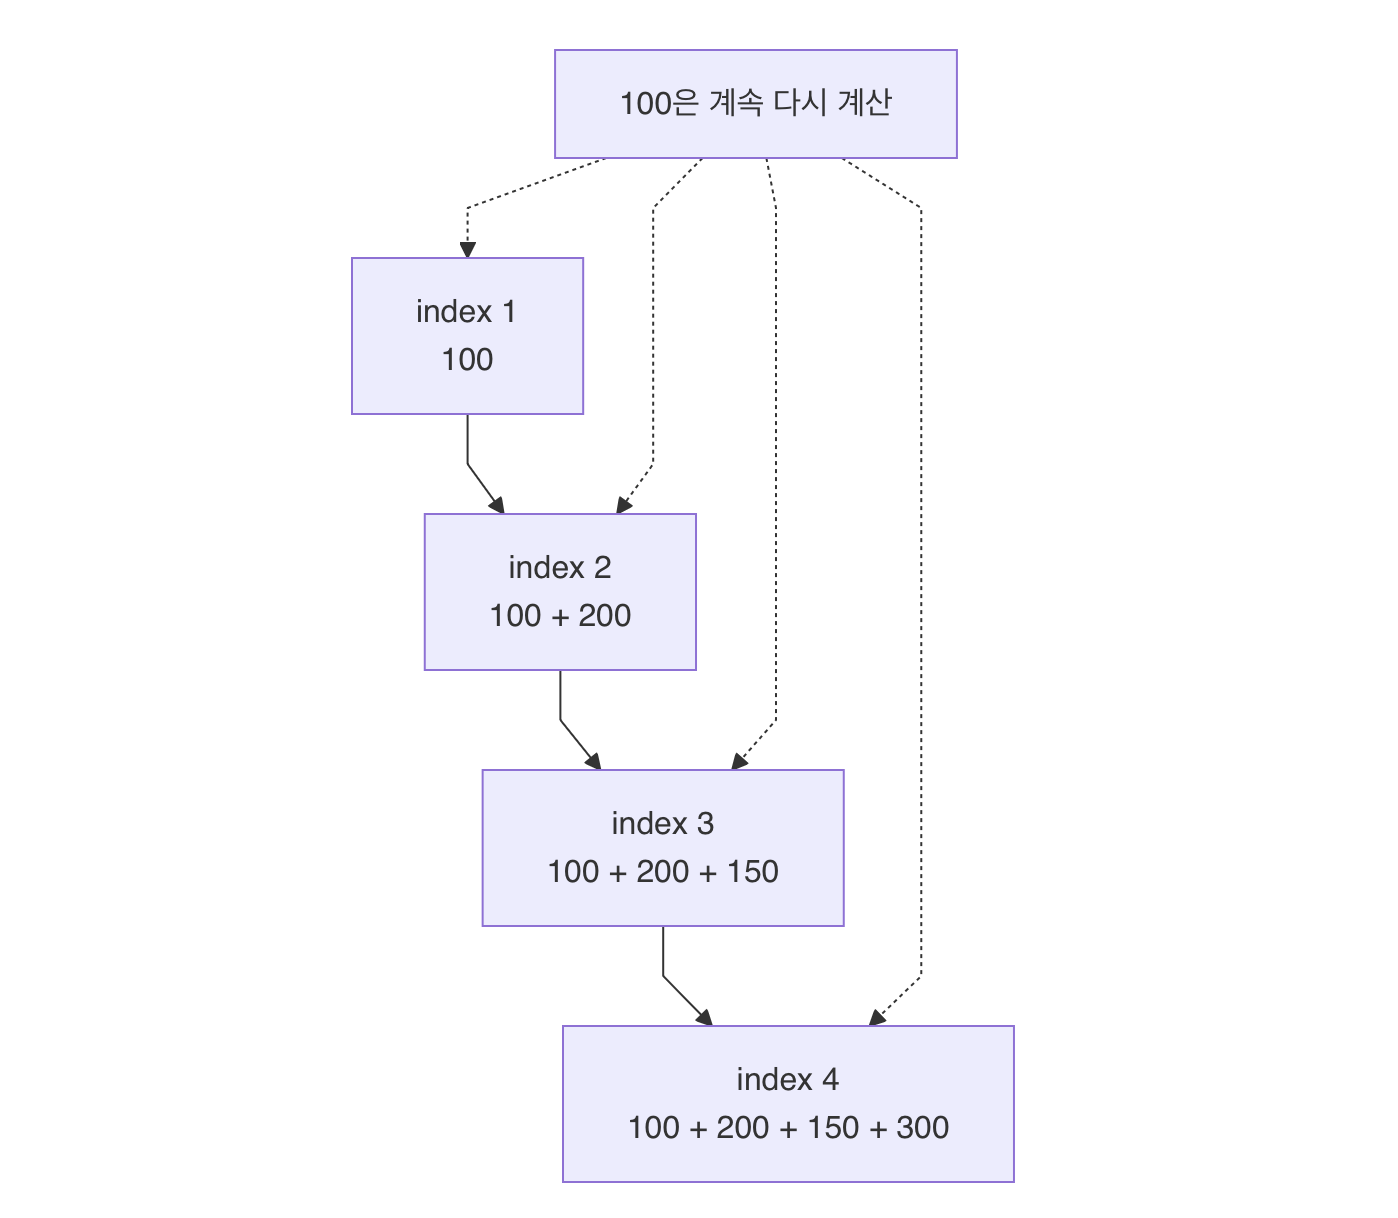
즉 이전에 이미 계산했던 값을 매번 처음부터 다시 계산하고 있다.
시간복잡도 생각해보기
배열의 크기를 N이라고 하면 첫 번째 원소는 비교하지 않으므로 for문은 실제로 약 N - 1번 실행된다.
그런데 각 반복에서 실행하는 sum(responseTimes[:index])의 계산량은 항상 같지 않다.
예를 들어 배열의 크기가 4라면 다음과 같다.
index 0 → skip
index 1 → sum([0])       → 1개 원소 계산
index 2 → sum([0, 1])    → 2개 원소 계산
index 3 → sum([0, 1, 2]) → 3개 원소 계산즉 for문은 N - 1번 돌지만, 각 반복 안에서 sum()이 처리하는 원소의 수가 점점 늘어난다.
전체 계산량을 합치면 대략
1 + 2 + 3 + ... + (N - 1)이 된다.
그림으로 보면 아래처럼 계산량이 삼각형처럼 쌓인다.
index 1   ■
index 2   ■ ■
index 3   ■ ■ ■
index 4   ■ ■ ■ ■
index 5   ■ ■ ■ ■ ■
...이 합은
N(N - 1) / 2이고, 전개하면 대략 N² / 2에 비례한다.
Big-O 표기에서는 상수와 낮은 차수의 항을 제외하므로 시간복잡도는
O(N²)이 된다.
이번 문제는 최대 입력 크기가 1,000이라 이 풀이도 충분히 동작할 수 있지만, 같은 계산을 반복하고 있기 때문에 더 효율적으로 개선할 수 있다.
이전에 계산했던 정보를 저장해두면 안 될까?
핵심 아이디어: 매번 다시 더하지 말고 합계를 기억하자
이 문제에서 평균을 구하려면 필요한 정보는 사실 딱 두 가지다.
이전 원소들의 합
이전 원소들의 개수그런데 현재 index가 i라면 이전 원소의 개수는 이미 i개다.
따라서 우리가 따로 기억해야 할 값은 이전 원소들의 합뿐이다.
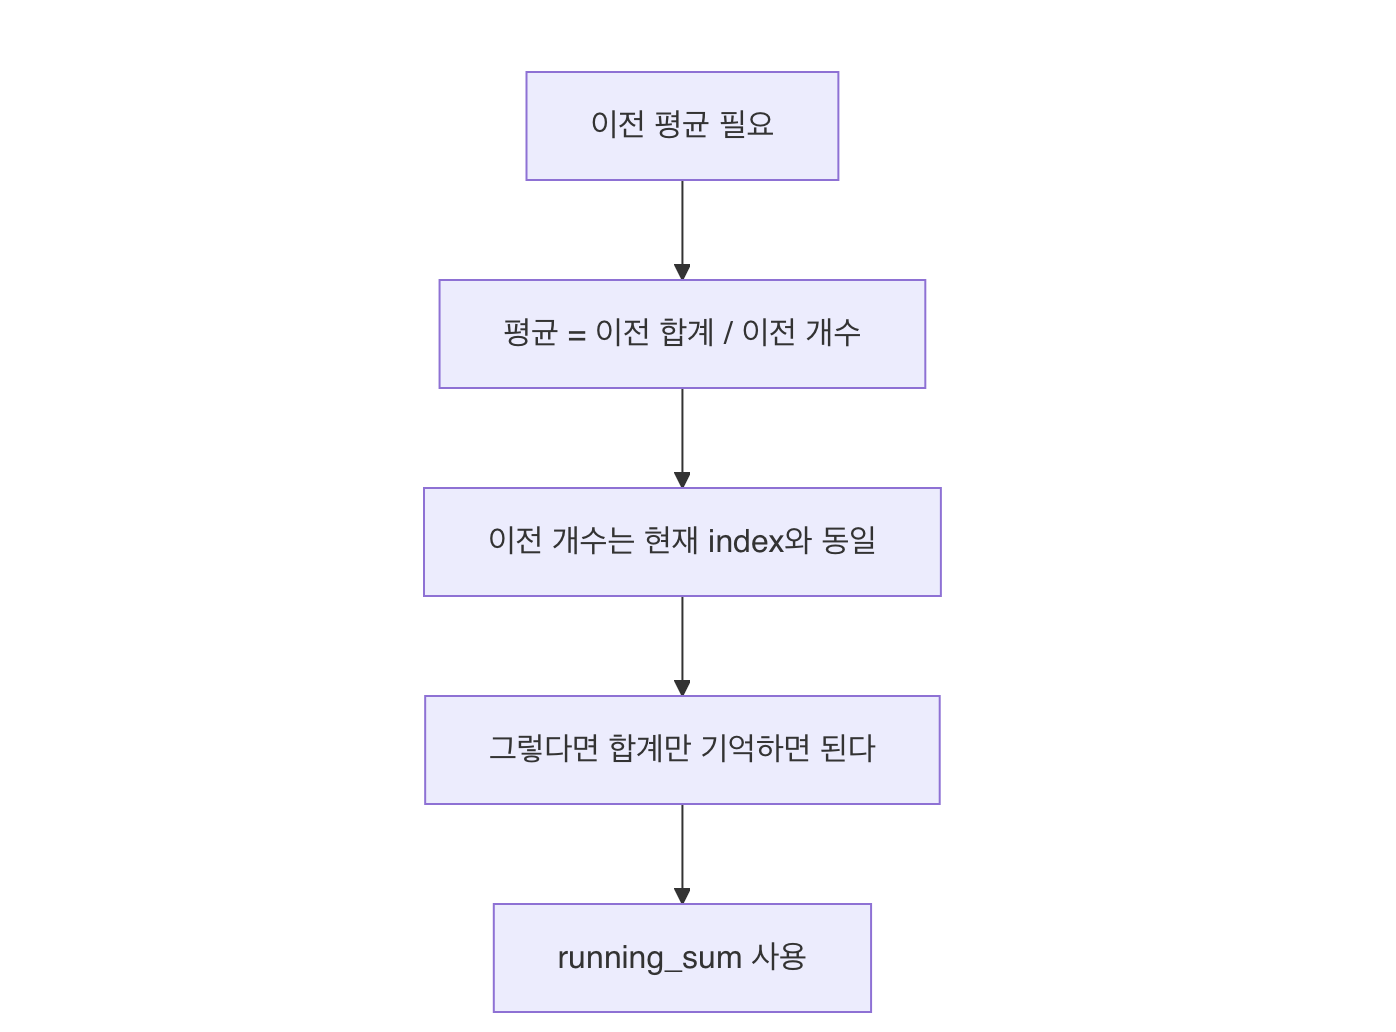
이런 방식으로 지금까지의 합을 계속 저장하는 것을 Running Sum, 또는 누적합 형태의 사고라고 볼 수 있다.
Running Sum으로 직접 따라가기
입력은
responseTimes = [100, 200, 150, 300]이다.
처음에는
running_sum = 100으로 시작한다.
index = 1
현재 값
200이전 값의 합
100이전 원소 개수
1평균
100 / 1 = 100비교
200 > 100true이므로 count를 증가시킨다.
그 다음 현재 값까지 누적한다.
running_sum
= 100 + 200
= 300index = 2
현재 값은
150이미 이전 합계를 기억하고 있다.
running_sum = 300따라서 이전 배열인 [100, 200]을 다시 더할 필요가 없다.
평균은
300 / 2
= 150이다.
150 > 150은 false.
현재 값을 누적한다.
running_sum
= 300 + 150
= 450index = 3
현재 값은
300이전 합계는 이미
450이다.
평균은
450 / 3
= 150따라서
300 > 150true.
count가 증가한다.
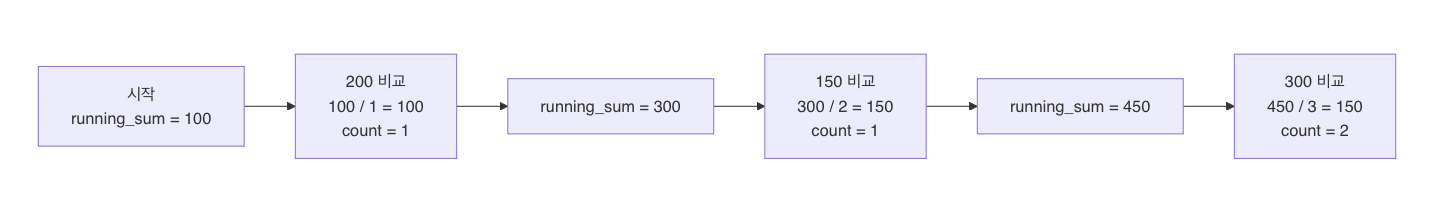
핵심은
이전 값들을 다시 조회하는 것이 아니라, 이전 계산 결과를 상태로 가지고 간다.
는 점이다.
O(N)으로 개선한 풀이
def countResponseTimeRegressions(responseTimes):
    if len(responseTimes) <= 1:
        return 0

    regression_count = 0
    running_sum = responseTimes[0]

    for index in range(1, len(responseTimes)):
        previous_average = running_sum / index

        if responseTimes[index] > previous_average:
            regression_count += 1

        running_sum += responseTimes[index]

    return regression_count
왜 O(N)이 되었을까?
이전 풀이에서는 각 위치마다 이전 원소들을 다시 읽었다.
하지만 개선된 풀이에서는 각 원소를 사실상 한 번씩만 처리한다.
100 → 한 번
200 → 한 번
150 → 한 번
300 → 한 번따라서 시간복잡도는
O(N)이다.
그리고 별도의 배열을 새로 만들지 않고
regression_count
running_sum
previous_average정도의 변수만 사용하므로 공간복잡도는
O(1)이다.
두 풀이 비교
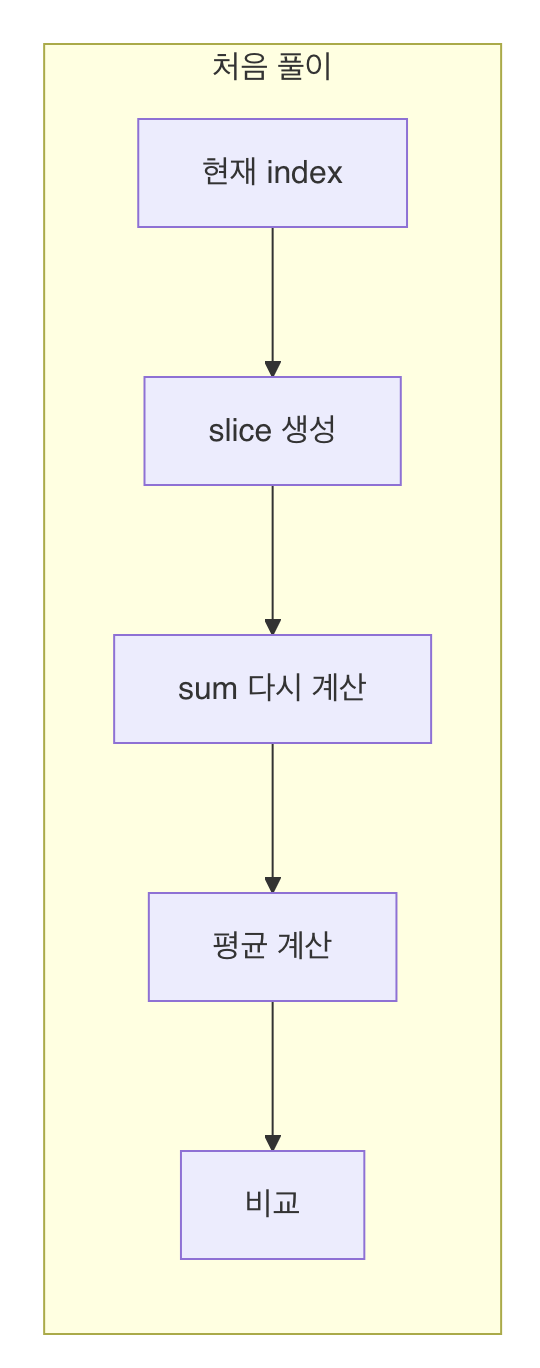
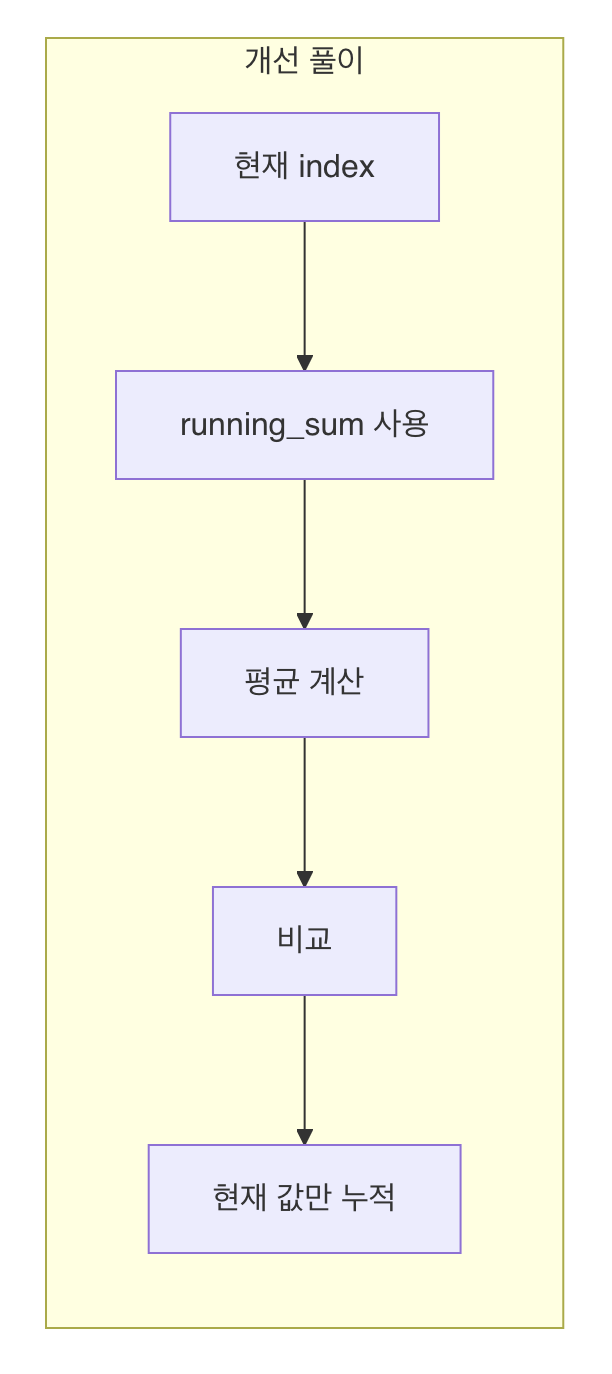
| 구분 | 처음 풀이 | 개선 풀이 |
|---|---|---|
| 이전 값 접근 | 매번 slice 생성 | 필요 없음 |
| 합계 계산 | 매번 다시 계산 | 누적값 재사용 |
| 시간복잡도 | O(N²) | O(N) |
| 공간복잡도 | slice 때문에 추가 사용 | O(1) |
| 이해 난이도 | 매우 직관적 | 약간의 사고 필요 |
조금 더 개선하면 나눗셈도 필요 없다
현재 비교식은 다음과 같다.
response_time > running_sum / index양쪽에 index를 곱하면
response_time × index > running_sum이 된다.
즉 평균을 직접 계산하지 않고도 비교할 수 있다.
따라서 코드도 다음처럼 작성할 수 있다.
def countResponseTimeRegressions(responseTimes):
    regression_count = 0
    running_sum = 0

    for index, response_time in enumerate(responseTimes):
        if index > 0 and response_time * index > running_sum:
            regression_count += 1

        running_sum += response_time

return regression_count이 방식은 나눗셈을 하지 않아도 되고 코드도 간결하다.
다만 처음 문제를 이해하는 단계에서는
previous_average = running_sum / index처럼 평균을 명시적으로 계산하는 풀이가 문제의 의미를 더 잘 보여주는 것 같다.
알고리즘 초보라면 먼저 이해하기 쉬운 코드를 만들고, 그다음 줄이는 편이 좋을 것 같다.
내가 이번 문제에서 가져가야 할 패턴
이번 문제의 핵심은 responseTimes가 아니다.
비슷한 문제가 나중에 전혀 다른 이름으로 나올 수도 있다.
예를 들어 문제에 이런 표현이 등장한다면
이전 값들의 합
지금까지의 평균
현재까지 누적된 값
앞에서 나온 모든 숫자의 합
지금까지의 총합다음 질문을 떠올려야 한다.
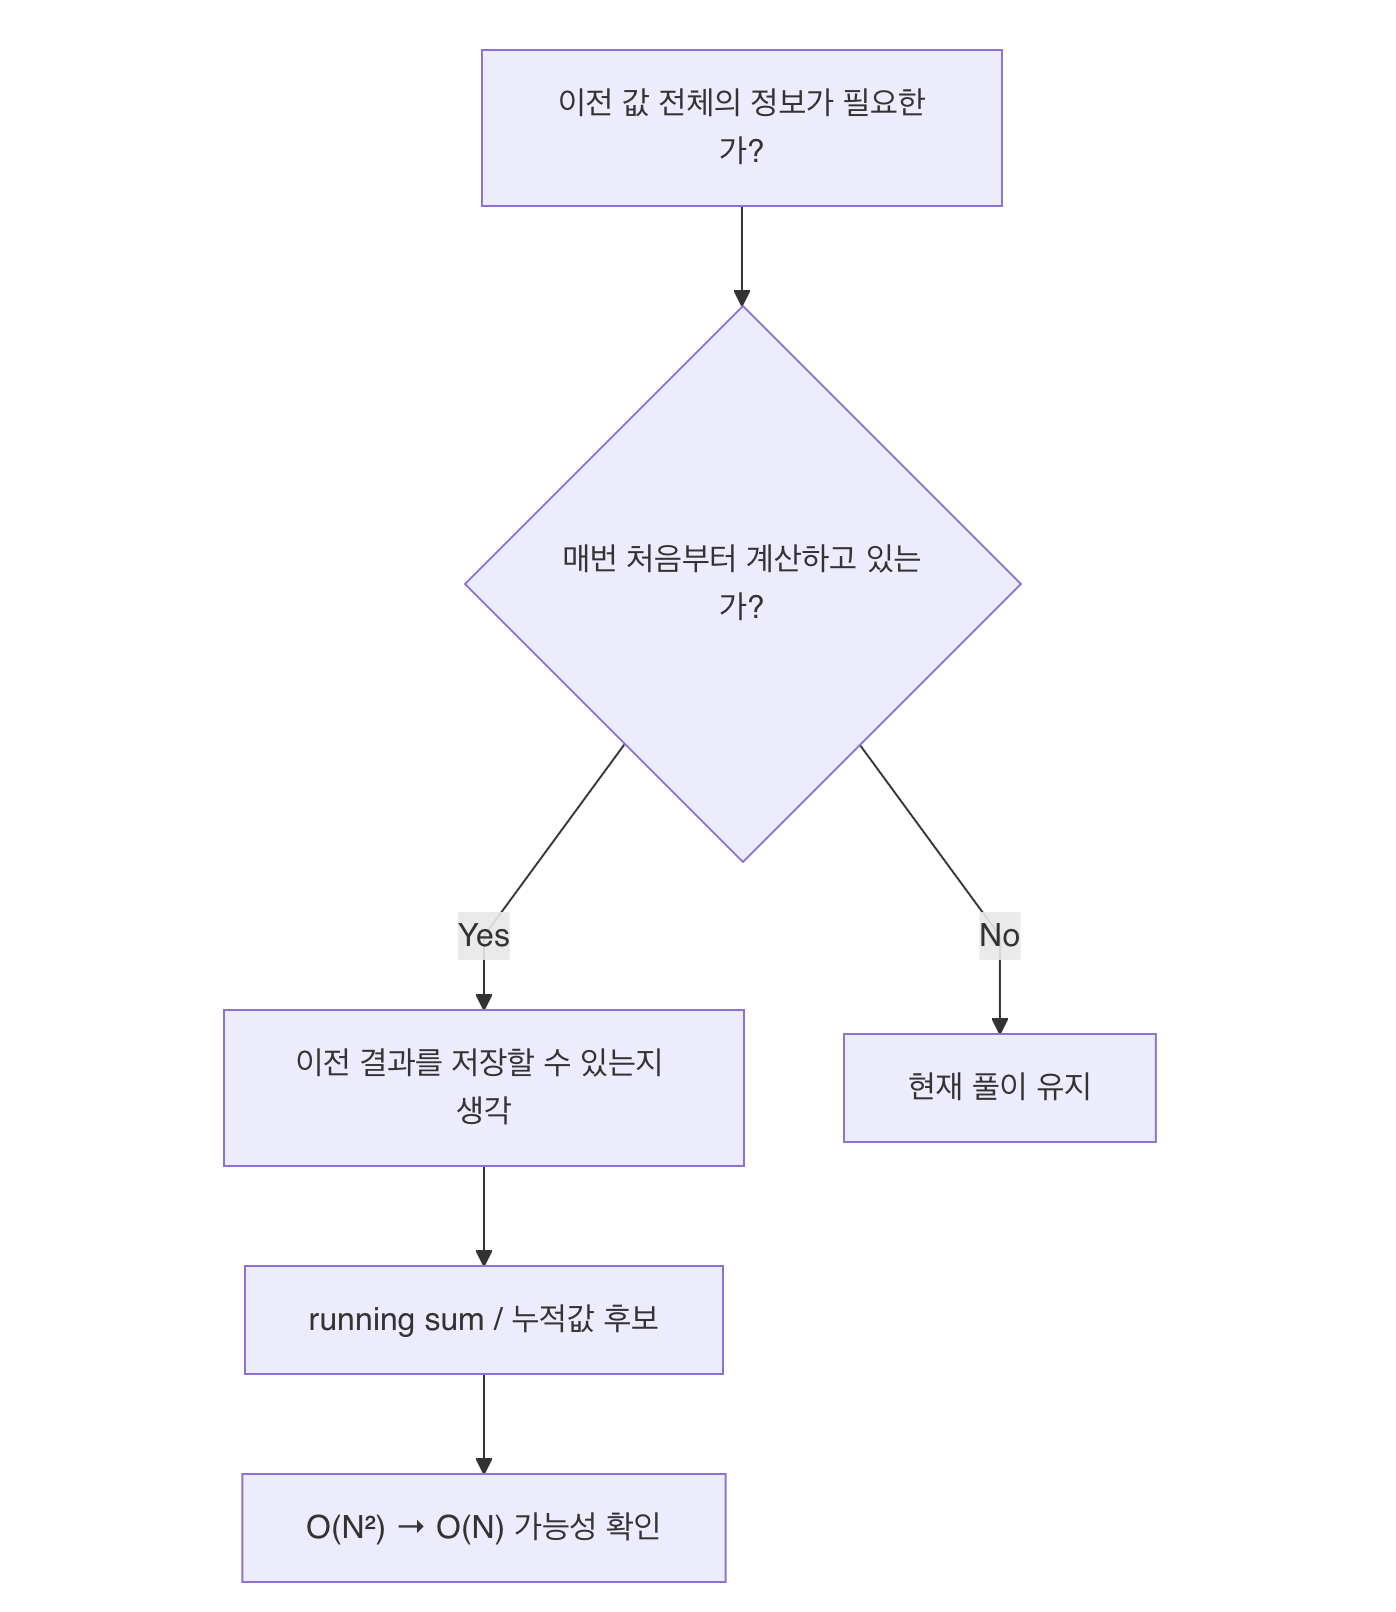
즉,
같은 계산을 반복하고 있다면 이전 계산 결과를 재사용할 수 있는지 확인한다.
이 패턴을 기억하는 것이 이번 문제의 가장 큰 수확인 것 같다.
이번 문제를 풀면서 정리한 사고 순서
앞으로도 알고리즘 문제를 풀 때 이 순서를 반복해보려고 한다.
알고리즘 공부를 막 시작한 입장에서는 처음부터 가장 좋은 풀이를 생각하려고 하기보다
일단 맞게 풀기
→ 왜 맞는지 이해하기
→ 얼마나 느린지 보기
→ 중복을 찾기
→ 개선하기순서가 더 공부가 잘 되는 것 같다.
정리
처음에는 다음처럼 이전 배열을 매번 잘라서 평균을 구했다.
sum(responseTimes[:index]) / len(responseTimes[:index])이 방식은 직관적이지만 이전 값을 반복해서 계산하기 때문에
O(N²)의 시간복잡도를 가진다.
반면 이전 합계를 running_sum으로 기억하면
running_sum += response_time매번 과거 데이터를 다시 계산할 필요가 없다.
그래서
시간복잡도 O(N)
공간복잡도 O(1)으로 개선할 수 있었다.
이번 문제에서 기억할 한 문장은 이것이다.
이전 모든 원소의 합이나 평균이 반복해서 필요하다면, 매번 다시 계산하지 말고 누적값을 유지할 수 있는지 먼저 생각해보자.
